複数カメラをオンボードで:FPGA/MPSoC がエッジでリアルタイム AI 推論を動かす仕組み
ライン上の 4 台のカメラをすべてセンターサーバへ戻して検出させると、帯域が追いつかずレイテンシも圧縮できない。よい道はキャプチャ・前処理・推論をボード上で行い、検出結果と圧縮プレビューだけを返すこと。本稿はエッジ・オンボード AI のアーキテクチャを PS/PL の役割分担、帯域予算、モデルデプロイ経路に分解する。
1. なぜ AI 推論をボードに載せるのか
多カメララインの旧来型セントラル方式:各カメラをスイッチに繋ぎ、生ストリームをセンターサーバへ戻し、サーバの GPU がすべてを検出する。カメラが少ないうちは動くが、チャネルが増えると 2 つの問題が立ち上がる:生の非圧縮帯域が巨大なこと、集中推論には避けられないネットワーク往復とキューイング遅延が乗ることだ。
まず生帯域の計算:1080p30・YUV422(1 画素 2 バイト)の生ストリーム 1 本 = 1920×1080×2×30 ≈ 124 MB/s ≈ 995 Mb/s。4 チャネル積み上げると約 4 Gb/s の非圧縮フロー、これはサーバ側のデコード・キューイング・符号化オーバーヘッドの前の値。この規模ではセントラル構成のリンクコストとエンドツーエンド遅延は下げきれない。
オンボード方式はこれを逆転させる:ボードが前処理と推論をローカルで行い、構造化された結果(バウンディングボックス、クラス、確信度、1 フレーム数 KB)と圧縮プレビュー 1 本だけを送り、生の画素はボードから出ない。
2. オンボード AI アーキ:PS と PL がそれぞれ何を持つか
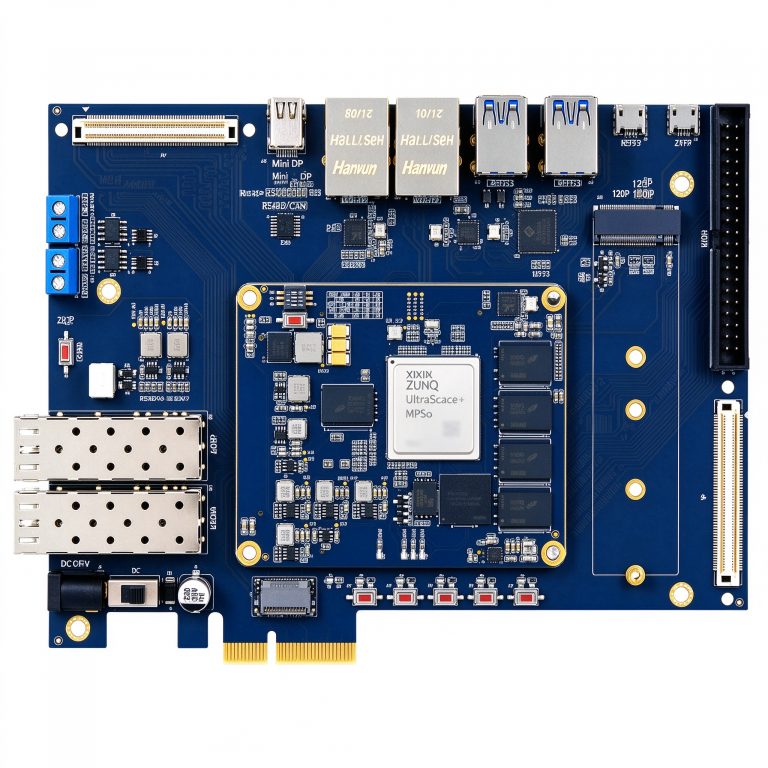
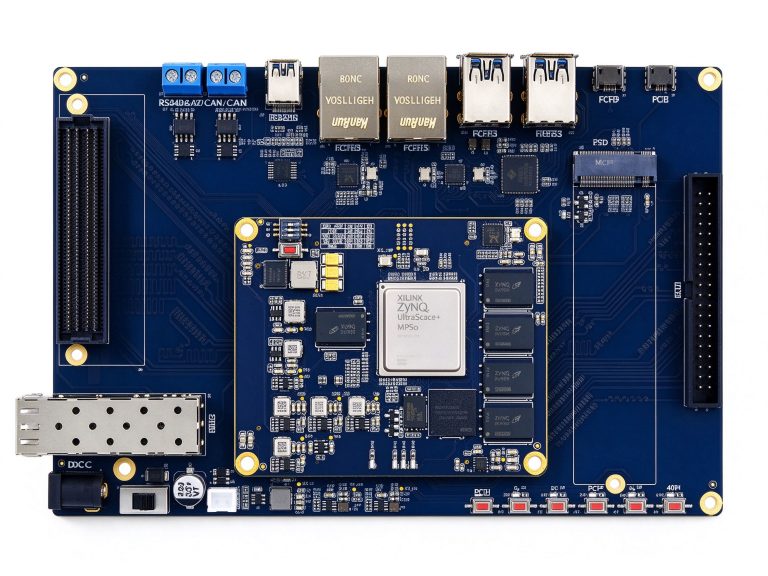
Zynq UltraScale+ MPSoC はクアッドコア A53 アプリケーションプロセッサ(PS)とプログラマブルロジック(PL)を 1 チップに収め、「スケジューリング + システム」と「並列データパス」を一致させる。
1. PL:キャプチャと前処理パイプライン
カメラ信号(MIPI CSI、USB または GigE)が PL に入り、ハードウェア並列でノイズ除去、スケーリング、色空間変換、フォーマット正規化を先に実行する。これらの処理は本来 1 画素ごとで並列、PL パイプラインは逐次 CPU よりはるかに速く、A53 を解放する。
2. PL:量子化モデルの並列推論
畳み込み、プーリング、活性化は DSP スライスの並列アレイとして PL で走る。重みはオンチップの Block RAM/UltraRAM または PL 側 DDR4 に置き、入力特徴マップが積和アレイを流れる。INT8 量子化後はモデルサイズとメモリトラフィックが急減する。PL は OS を載せず、決定論的パイプラインがフレームごとに固定のテンポを保つ。
3. PS:スケジューリング、Linux、結果報告
PS のクアッド A53 が Linux を動かし、タスクスケジューリング、ホスト通信、結果パッケージを担う。内蔵 VCU エンコーダが同時にプレビュー 1 本を H.264/H.265 へ圧縮し、人が見るときだけネットワークへ送る。
3. 帯域予算:なぜ生の多カメラフローは戻せないのか
| リンク段階 | 1080p30 単独 | 4 チャネル | 備考 |
|---|---|---|---|
| 生非圧縮(YUV422) | 約 995 Mb/s | 約 4.0 Gb/s | 旧来の全サーバ戻し方式 |
| 前処理後の構造化結果 | 数 KB/フレーム | 数 KB/フレーム | ボックス + クラス + 確信度 |
| 圧縮プレビュー(H.264) | 2–4 Mb/s | 8–16 Mb/s | 見るときだけ送信 |
オンボード処理が上り帯域を Gb/s から Mb/s、あるいは Kb/s へ切り下げ、センターサーバは結果だけを受け取り、カメラごとのデコードと推論予約をしなくてよい。「生画素はボードに留まり結果だけが出る」この境界が、セントラル方式に対するエッジの核心的アドバンテージだ。
4. モデル展開とボード選定
1. まず量子化とプルーニング
モデルをオンボードで INT8 に量子化し、プルーニングで重みを削って体積を縮小する。次にレイヤパイプラインをオンチップストレージと DSP 容量で分割し、重みテーブル全体を一度にチップへ入れなくてよい構成にする。Vitis-AI 風のフローがモデルをコンパイル・量子化して PL 加速ユニットへ展開し、PS の Linux はアプリをホストし続ける。
2. チャネル数と演算量でボードを選ぶ
エッジビジョンボードの役割:エントリー試作 / 多チャネル演算 / ピュア FPGA 並列
- エントリーエッジ試作(DUUZ4EV、RFQ):XCZU4EV、192K ロジックセル、728 DSP、内蔵 VCU、PS 4GB + PL 4GB DDR4。1–2 カメラのエッジ AI 試作と PYNQ 高速検証向け。
- 多チャネル高演算(DUUZ5EV、RFQ):XCZU5EV、256K ロジックセル、1,248 DSP、16 GTH ペア、FMC-LPC 拡張。より多いチャネルと重いモデルを載せるプラットフォーム。
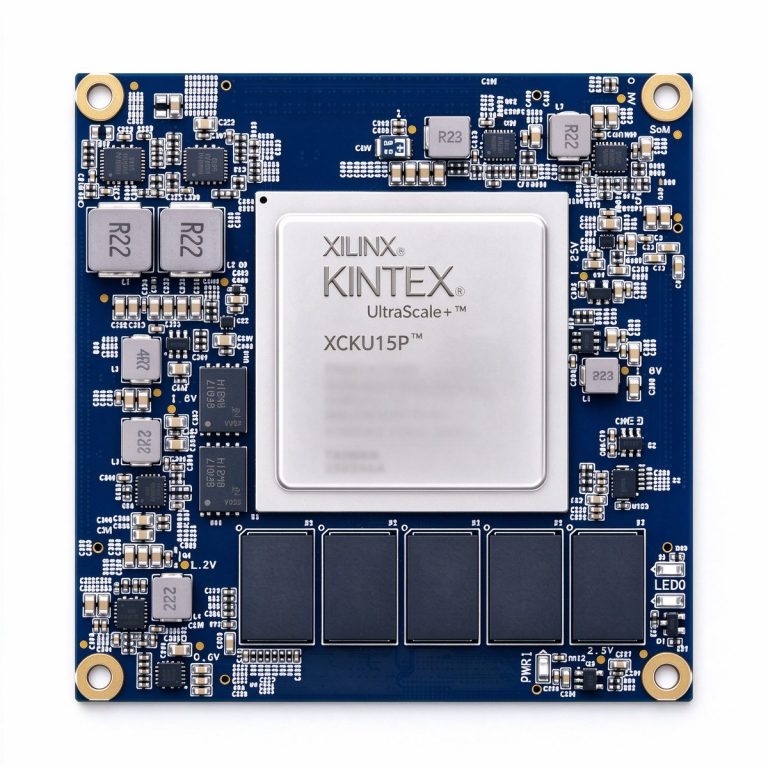
- ピュア FPGA 並列拡張(XCKU15P、¥15,999):Kintex UltraScale+ コアボード。PS システムが不要な多カメラ並列ストリーム処理と高速集約向け。
エッジ AI 推論とは、サーバ GPU を縮めることではない。「キャプチャ–前処理–推論–報告」の链全体をボード上でスライスすることだ。PL が並列画素処理と量子化畳み込みを持ち、PS がスケジューリングと通信を持ち、VCU が途中でプレビューを圧縮する。生画素はボードに留まり結果だけが出る——帯域も遅延も同時に緩む。