医療用超音波ビームフォーミング:128 チャネル信号链とデータレート予算
128 チャネルのカラー超音波プローブは、各チャネルを 12-bit・40 MS/s ADC でサンプリングし、生データレートは約 7.7 GB/s に達する——CPU が吸収できるどころか、リアルタイム画像化など論理でない。正しいアプローチは、ビームフォーミング・包絡線検波・ダウンサンプリングを先に FPGA 内部で実行し、圧縮した画像データだけをホストに渡すこと。本稿では 128 チャネルの信号链を段階分解し、各段のデータレートを予算化し、FPGA がその間で具体的に何をするかを解説する。
1. 超音波イメージングの全信号链
プローブアレイから画面上のグレースケール画像まで、信号は長い链をたどり、FPGA はアナログフロントエンドの後、ホスト画像処理の前に位置する:
1. プローブアレイ(128 素子):超音波を送信し、組織のエコーを受信。各素子が独立した 1 チャネルに対応。
2. アナログフロントエンド(AFE):TGC 時間利得補償 → 帯域通過フィルタ → 可変利得増幅 → ADC デジタル化。
3. FPGA ビームフォーミング:チャネルごとにプログラム可能な遅延、重み付け、加算を行い 1 本の走査線を合成し、動的フォーカスを完成させる。
4. IQ 復調 + ダウンサンプリング + 包絡線検波:高周波 RF 信号を振幅グレースケールデータへ圧縮。
5. スキャンコンバージョン + フレームバッファ + PCIe アップロード:極座標の走査線を直交座標へ変換し、ホストへ送って DSC とカラーマッピング。
ステップ 3 と 4 を FPGA でやらなければならない理由は明快——128 チャネルをマイクロ秒単位で整合・遅延・重み付け加算し、各遅延が深度とともに動的に変化する必要があるからだ。これは高度に並列な、チャネルごとの、決定論的タイミングの仕事。汎用 CPU 上のソフトウェアには、並列性もリアルタイムフレームレートも足りない。
2. 128 チャネルのデータレート予算(接続前に計算する)
予算は単チャネル ADC から始めて逓増する。12-bit・40 MS/s ADC の場合:
| 段階 | チャネルあたりレート | 128 チャネル合計 | 備考 |
|---|---|---|---|
| ADC 生サンプリング | 12 bit × 40 MS/s = 480 Mb/s(60 MB/s) | 128 × 480 = 61440 Mb/s ≈ 61.4 Gb/s(7.68 GB/s) | FPGA に入る生ピーク |
| ビームフォーミング(遅延和) | 128 チャネルを重み付け加算 → 1 走査線 | 加算後は並列パスでなくなる | 並列性はここで圧縮される |
| IQ 復調 + CIC/FIR ダウンサンプル | RF 40 MS/s → 約 10 MS/s 相当 | 単パス 約 20 MB/s(複素 12-bit) | デシメーション後は生の 1/4 未満 |
| 包絡線検波 + 対数圧縮 | 8-bit 振幅、約 10 MS/s | 単パス 約 10 MB/s | ダイナミックレンジを 40–60 dB に圧縮 |
| PCIe ホストアップロード | — | 256 線 × 60 fps × 8 bit ≈ 122 MB/s | CPU が扱えるのはこのレベル |
核心的結論:圧縮は FPGA 内部で起きる。FPGA に入るのは 61.4 Gb/s の生並列ストリーム、ホストに出るのは約 122 MB/s のグレースケールフレームデータだけ。圧縮比は 60 倍を超える——128 パスを 1 つに併合するビームフォーミングと、高周波 RF を振幅包絡線へ畳み込むダウンサンプリングと検波によって実現する。FPGA を飛ばして 7.68 GB/s の生ストリームを CPU に押し込めば、メモリ帯域も PCIe も捌ききれない。
フレームレートと走査線数の関係
ビームフォーミングでは、各走査線ごとに新たな 128 チャネル遅延和が必要。1 フレームに N 本の線をフレームレート F で持つとき、FPGA は 1 秒あたり N×F 回の加算を完了させなければならない。N=256、F=60 fps なら 256 × 60 = 毎秒 15360 本の走査線、各線で 128 個の重み付き遅延サンプルを加算——これが FPGA の乗算器(DSP)とオンチップ RAM(遅延線 FIFO)のサイジング出発点だ。
3. FPGA 内部の信号链の分担
1. 同期収録とチャネル整合
128 チャネルは通常いくつかの AFE にまたがり、JESD204B またはパラレル LVDS で FPGA に入る。最初の関門はスキュー補正——トレース長はチャネルごとに異なるため、サンプルを FIFO の前に単一クロックリファレンスへ整合させる。さもないと遅延和の位相がずれ、サイドローブやゴーストアーチファクトを生む。
2. 動的フォーカス遅延和
各素子はフォーカス点までの距離が異なるため、エコーの到達時刻がずれる。FPGA はこの時間差を、プログラム可能な遅延線(深度調整可能 FIFO またはタップ付き遅延)でチャネルごとに補償し、次にアポダイゼーション重みを乗じて加算する。フォーカス深度は時間ゲートとともに動くため、遅延パラメータはセグメントごとに更新され、オンチップ BRAM と乗算加算用 DSP を大量に消費する。
3. IQ 復調・ダウンサンプリング・包絡線検波
加算された RF 線はまず直交復調(I/Q ミキシング)を通り、次に CIC + FIR のカスケードがサンプルレートをデシメーション。ヒルベルト変換が包絡線を求め、対数圧縮が広いダイナミックレンジを 8-bit グレースケールへ写像する。この段階は典型的なパイプラインフィルタ処理——DSP 使用率は高いが並列度は低い。
4. スキャンコンバージョン・フレームバッファ・アップロード
扇形の極座標走査線を直交座標の矩形ピクセルへ再サンプリングし、DDR3/4 のフレームバッファに書き込んだ後、DMA がフレーム全体を PCIe でホストへ送る。この段階は DSP スループットではなく、DDR 読み書き帯域と DMA エンジンが問題になる。
4. エンジニアリング事例:ポータブルカラー超音波フロントエンドのサイジング
ポータブルカラー超音波フロントエンドは、128 チャネル AFE で RF を 40 MS/s・12-bit サンプリングする。ビームフォーミングは 128 本の遅延線と重み付け乗算を並列処理し、血流ドップラーチャネルを加える。上記予算のとおり、生 61.4 Gb/s は FPGA 内部で約 122 MB/s のグレースケールフレームへ圧縮され、PCIe Gen2 x4 の実効帯域で余裕を持って搬送できる。
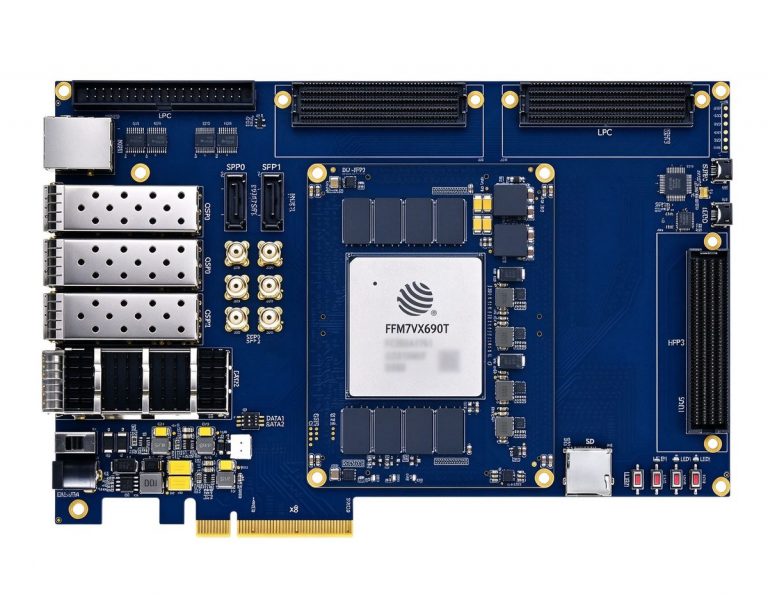
- 大容量型(DUF7690T / JFM7VX690T):128 本の遅延線 FIFO、グレースケール合成、ドップラーチャネルを同時に保持するロジックとオンチップ RAM が十分——フル 128 チャネル・高フレームレート設計向け。
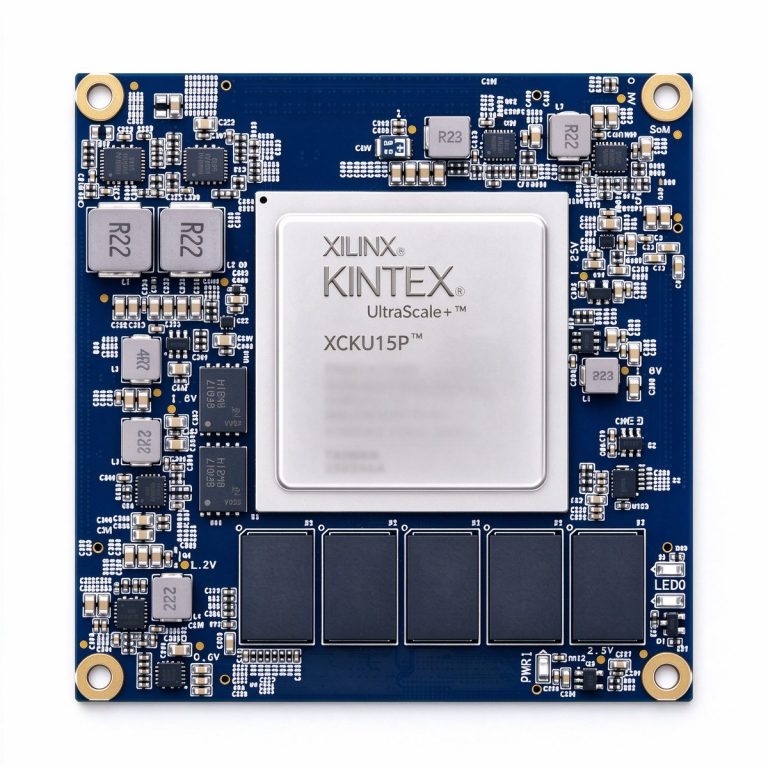
- 高チャネル拡張型(XCKU15P):強力なトランシーバと多チャネル LVDS 集約——チャネル拡張や、AFE データを光で戻す分散プローブ向け。
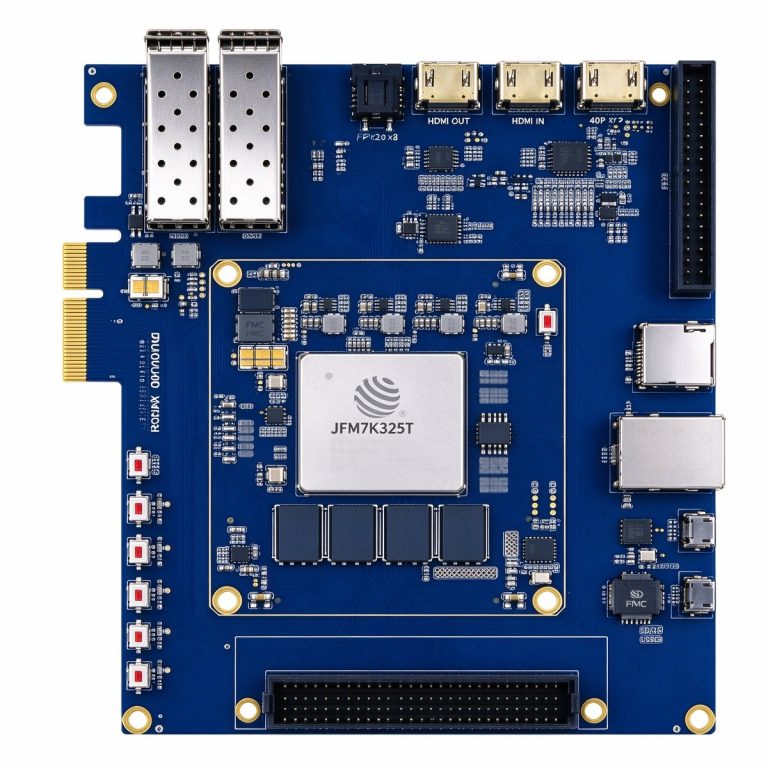
- ミドルクラス入門(DUK7325T / JFM7K325T):リソースとコストのバランス——64–128 チャネルのグレースケール試作と中下位製品向け。遅延和・検波の链をここで回してから大容量プラットフォームへ。
超音波イメージングの本質は、FPGA 内部の並列遅延和によって 128 本の高速生エコーを 1 本の走査線へ変えること。データレート予算が明確になれば——フロントエンド 61.4 Gb/s、アップロード 122 MB/s——どの処理をチップ内に残し、どれをホストへ渡せるかが分かる。医療超音波において FPGA はアクセラレータカードではなく、画像そのものである。