10G/25G 光バックホール:GTX/GTH ライトレートと UDP オフロードの設計
複数の高速 ADC、レーダビーム、映像ストリームが集まると、銅ケーブルは数メートルで頭打ち、PCIe は筐体から出せない。正しいバックホールは FPGA の GTX/GTH トランシーバから直接 SFP+/QSFP を駆動し、MAC と IP/UDP スタックをオンチップでオフロードし、ペイロードだけをライトレートで光に送り出すこと。本稿では 10G/25G のライトレート、UDP ペイロード、リンク予算、FPGA 内部の分担を計算する。
1. なぜ高速データに光バックホールが必要か
基板内部は PCIe、短いボード間は銅線で足りる。だが収録ノードが分散配置され、距離が数メートルを超え、各チャネルが数 Gb/s 以上になると、銅とバックプレーンが先に頭打ちになる:
1. 距離の壁:10G の DAC ケーブルは通常 3–5 m しか届かず、アクティブ銅線も同様。単一モード光 + 光モジュールなら 10 km が容易で、分散収録アレイや遠隔レーダフロントに適する。
2. 帯域の壁:1080p60 の映像、多チャネル SDR IF、マージされたレーダ IQ は 10 Gb/s を超えることが珍しくない。ギガビット銅やバックプレーンでは運べず、SFP+(10G)または QSFP28(25G/100G)が要る。
3. タイミングとノイズ耐性:ノイズの多い産業環境では、光が電気的アイソレーションを提供し、クロストークやグランドループに強く、ノード間の共通タイミングも安定する。
典型的な構成:遠隔収録カードは ADC サンプリングと前処理だけを行い、結果をパッケージして 1 本の光でセンターサーバへ送る。センターはチャネルを個別処理せず、集約ストリームを受けるだけ。ここではリンクのライトレートとプロトコルオーバーヘッドが、接続可能なノード数を直接決める。
2. 10G/25G ライトレートと UDP ペイロード予算(先にペイロードを計算する)
「10 Gb/s ポート」をそのまま使える帯域だと思い込む人が多いが、アプリケーション層に届くのは符号化・IFG・プロトコルヘッダを引いたペイロードだ。ライトレートの成り立ちから始める:
| 項目 | 10G(SFP+) | 25G(QSFP28) | 備考 |
|---|---|---|---|
| 公称イーサネットレート | 10.0 Gb/s | 25.0 Gb/s | 実効 MAC レート |
| 64b/66b 符号化後ライトレート | 10 × 66/64 = 10.3125 Gb/s | 25 × 66/64 = 25.78125 Gb/s | 線路上の実レート |
| MTU 1500 フレームオーバーヘッド | Preamble/SFD 8B + IFG 12B + Eth 14B + IP 20B + UDP 8B | 同左 | 1 フレームあたり約 62B がペイロード外 |
| UDP ペイロード比率 | 1500/(1500+62) = 96.03% | ≈96.03% | アプリ層の再送は含まず |
| UDP ペイロードレート(MTU1500) | 10 × 96.03% ≈ 9.60 Gb/s | 25 × 96.03% ≈ 24.0 Gb/s | アプリ層が実際に受け取る値 |
| ジャンボフレーム(9000B)比率 | 9000/9062 = 99.32% | 99.32% | ペイロードを約 9.93 / 約 24.8 Gb/s へ引き上げ |
核心的結論:MTU1500 の UDP では、10G ポートがアプリに届けるのは 10 Gb/s ではなく約 9.6 Gb/s だ。ノードはペイロードで見積もる:各ノードが実効 2 Gb/s を送るなら、10G リンクに載るのは 4–5 ノード(9.6 / 2、余裕込み)、フルの 5 ではない。ライトレートに近づけたいならジャンボフレームを有効化し、フレーム固定オーバーヘッドを償却する。
BER とリンク予算
光リンクは挿せば終わりではなく、まず光パワー予算を計算する:送信パワー − 受信感度 = リンクマージン、そこから光ファイバ減衰(単一モード 1310 nm ≈ 0.35 dB/km)とスプライス/コネクタ損失(コネクタ 1 個あたり約 0.5 dB)を引く。SR マルチモード 850 nm は距離と OM3/OM4 で制限を受け、LR 単一モード 1310 nm は 10 km まで届く。合格リンクは BER 1e-12 未満を目標とし、25G では一般に RS-FEC 前方誤り訂正を追加し、生の約 1e-5 を 1e-15 へ補正する——FEC の符号利得も予算に含める。
3. FPGA 内部の仕事分担
1. GTX/GTH トランシーバが光モジュールを駆動
Series-7 GTX は 10.3125 Gb/s が上限で SFP+ 10G に一致。UltraScale/UltraScale+ の GTH/GTY は 16G 超で 25G をサポート。トランシーバはシリアライズ/デシリアライズ、8b/10b または 64b/66b 符号化、クロックリカバリを担当し、外部には高速ペアとモジュール I2C 管理(DDM 読み出し)だけが残る。
2. MAC とフレーム処理
トランシーバの上に 10G/25G イーサネット MAC が乗る:フレーム区切り、CRC 検査、PAUSE フロー制御。Rx は CRC 不良フレームを捨て宛先 MAC でフィルタ、Tx はフレームをカプセル化し IFG を埋める。この層は決定論的なパイプラインであり、フルハードウェアに向く。
3. UDP オフロードエンジン
CPU がフレームごとに IP/UDP をパケット化すると 10G ではボトルネックになる。オンチップオフロード:ハードウェアが送信元/宛先 IP、ポート、チェックサムを埋め、ユーザは DMA バッファにペイロードを書くだけ、エンジンが Eth/IP/UDP ヘッダを付与しチェックサムを計算し MTU でフラグメントする。CPU はパケット化せず、初期化時にアドレステーブルを 1 回設定するだけ——これがプロトコルスタックオフロードだ。
4. エラー統計とリンク監視
オンチップカウンタが CRC エラー、廃棄フレーム、FEC 訂正数を集計し、管理チャネルで定期報告する。モジュールの DDM(Tx パワー、Rx 受光パワー、温度)も収集し、画像が壊れてから気づくのではなく、マージン低下を早期に警報する。
4. 工学事例:10G 光でバックホールする多ノード収録
分散収録システムに遠隔ノードが 4 台、各ノードが SDR IF 2 チャネルと映像 1 チャネルをマージし実効約 2.2 Gb/s をバックホールする。センターは 1 本の 10G 光で集約し、ジャンボフレームでペイロード約 9.9 Gb/s、4 ノード合計 8.8 Gb/s で余裕が残る。すべてのプロトコルは FPGA で UDP オフロードされ、ホストはペイロードを受けるだけ。
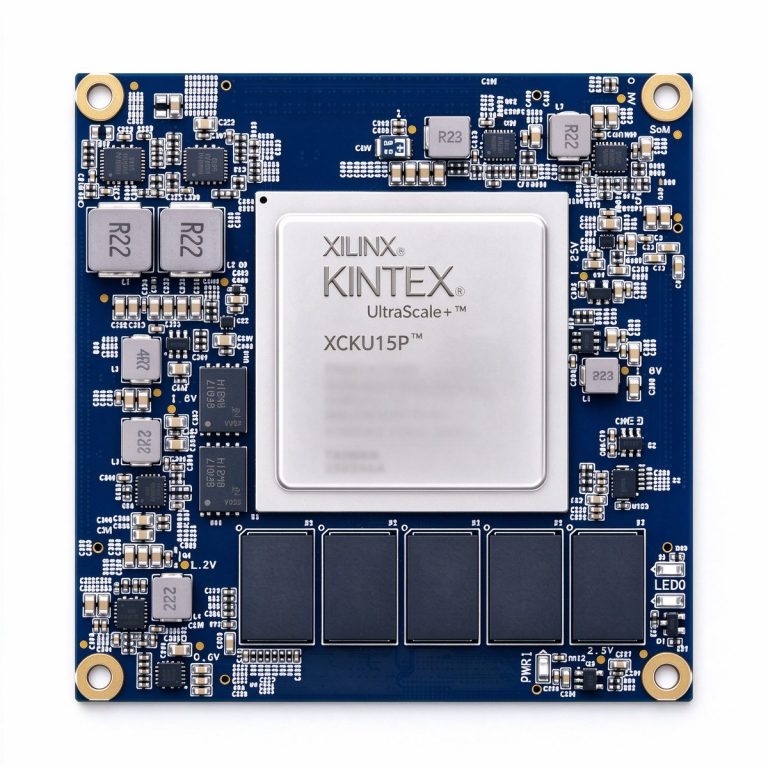
- 広帯域リンク(XCKU15P / Kintex UltraScale+):GTY トランシーバの余力が大きく 25G や複数 10G レーンに対応、25G/100G へスケールする可能性のある集約メインノード向け。
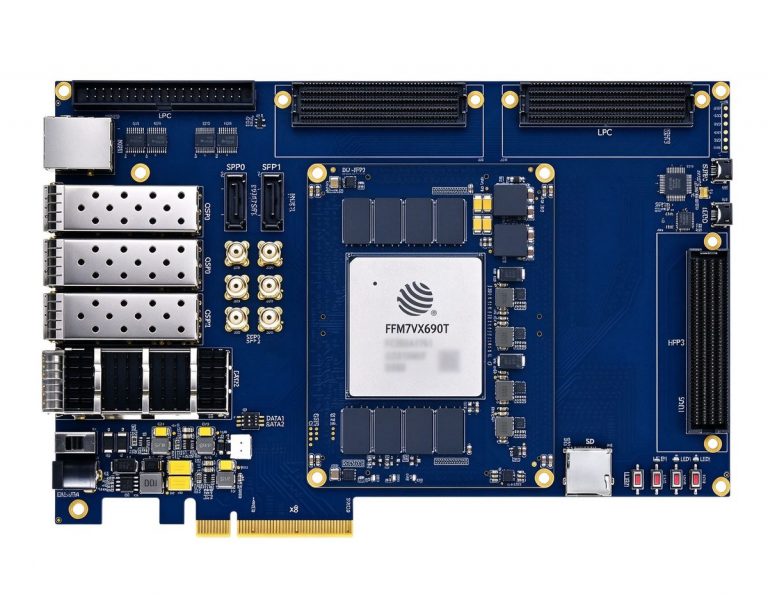
- 大容量集約(DUF7690T / JFM7VX690T):ロジックとオンチップ RAM が豊富で複数 MAC・UDP オフロードエンジン・大キューを持て、センターの多ノード集約とライトレード転送向け。
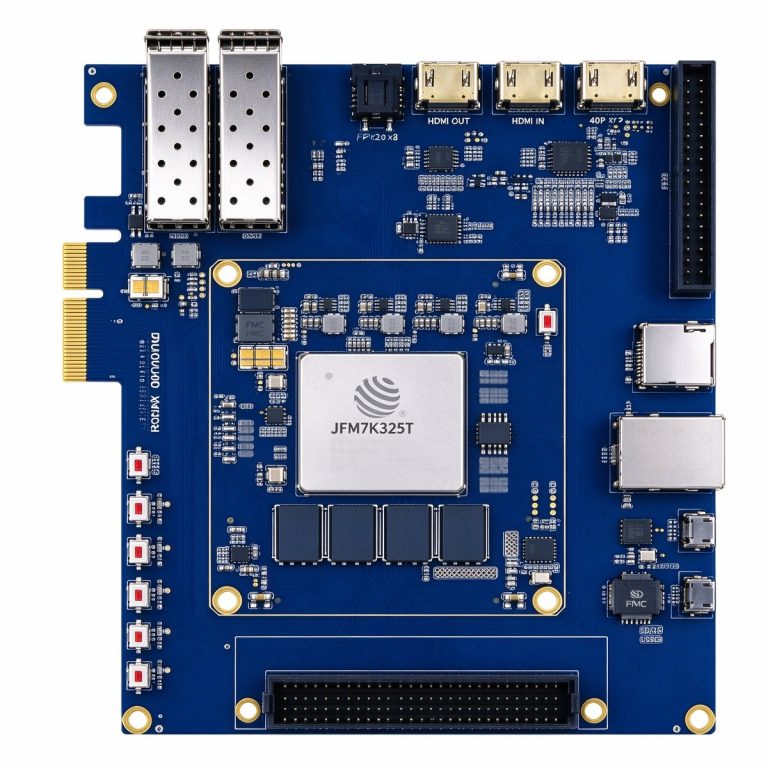
- 10G 試作エントリー(DUK7325T / JFM7K325T):Series-7 GTX が 10G ライトレートを飽和させコストも釣り合い、単ノードの 10G 試作とエントリー製品向け。
光バックホールの本質は、FPGA のトランシーバとハードウェアスタックに「ライトレートで送る」を代わりにやらせること。2 つの数字を覚えておく:MTU1500 では 10G が約 9.6 Gb/s、25G が約 24 Gb/s のペイロード。ノードは公称レートではなくペイロードで見積もり、リンク予算と BER を先に計算すれば、現場で速度が落ちることはなくなる。