量的取引における VU13P:マーケットデータ復号から発注執行までの低遅延ハードウェアプラットフォーム
量的取引の本質は、マーケットデータ到着・シグナル計算・発注送信という情報ループを最短時間で完了させること。本稿は AMD Virtex UltraScale+ XCVU13P(VU13P)プラットフォームを主线とし、なぜそれが量的取引に適し、どうやって届く低遅延トレーディングチェーンへ展開するかを解説する。
取引所マッチングエンジンのマイクロ秒スケールでは、遅延そのものがコストだ——1 マイクロ秒遅れれば価格スリッページ、機会損失、あるいは戦略全体の失敗を意味する。過去 10 年、有力なプロップ取引会社はチェーンの最もクリティカルな部分を CPU ソフトから FPGA ハードへ段階的に移してきた:カード上でのマーケットデータ復号、カード上のオーダーブック、カード上での戦略判断、カード上での発注生成だ。本稿は AMD Virtex UltraScale+ XCVU13P(VU13P)プラットフォームを主线に、なぜそれが量的取引に適し、どう展開するかを論じる。
1. 量的取引のレイテンシ構造:なぜ答えが FPGA なのか
典型的な自動取引チェーン——マーケットデータパケットが NIC に届いてから発注が NIC を出るまで——は、ネットワークスタック、マーケットデータ解析、オーダーブック保守、シグナル計算、リスクチェック、発注符号化を順に通過する。ソフトスタックではカーネル割り込み、プロトコルスタック処理、スレッドスケジューリング、キャッシュミスが制御不能なジッタを入れ込む;ハード実装はこれらの段を固定パイプライン深度へ変え、遅延を決定論的にし、割り込みもスケジューリングも排する。実装方式別の概算エンドツーエンド tick-to-trade 遅延:
| 実装方式 | 代表的エンドツーエンド遅延 |
|---|---|
| 普通のソフト + カーネルネットワークスタック | 10–100 µs |
| カーネルバイパスソフト(DPDK / Onload + コア固定) | 1–5 µs |
| フル FPGA チェーン(解析 → 戦略 → 発注) | 300 ns – 1 µs |
| FPGA プリアームトリガ(パターンマッチ送信) | 30–100 ns |
| レイヤ 1 スイッチ(純ファンアウト/複製) | 約 5 ns |
FPGA の 3 つの性質がこのオーダーの差を決める:並列性——複数のマーケットデータ feeds と戦略インスタンスがハード上で同時に競合なく走る;決定論性——割り込みもスケジューリングもなく、各パケットの処理遅延が固定、リスク管理と監査にとって等しく重要;近接性——光ポートが FPGA に直接入り、PCIe とプロトコルスタックを迂回し、パケットが届くなり復号する。業界の公開データがこれを裏付ける:一部ソリューションは往復 tick-to-trade 100 ns 未満を主張し、AMD がパートナーと CME 向けに作ったリファレンスデザインはプリアームトリガ遅延 25 ns 級を達成;*Computer Applications and Software* 2025 論文が OpenCL ベースの超低遅延マーケットデータ加速システムを記述し、Alveo U50 で 678 ns の最小マーケットデータ処理と 38.4 Gbit/s スループット、ソフト方式比約 12 倍を達成した。
2. VU13P プラットフォーム能力概要
VU13P は AMD Virtex UltraScale+ ファミリーに属し、「ロジック規模 × 高速インターフェース」の釣り合い点を代表するデバイスだ。AMD 公式製品ドキュメントによる主要諸元:
| 指標 | XCVU13P 仕様 |
|---|---|
| システムロジックセル | 3,780K(約 378 万) |
| DSP スライス | 12,288 |
| GTY 高速トランシーバ | 128 ペア(1 ペアあたり最大 32.75 Gb/s) |
| ユーザ IO | 832 |
| 統合高速インターフェース | PCIe Gen3 x16、100G イーサネット MAC、150G Interlaken(ダイ内ハードブロック) |
| DSP 演算 | 最大約 38 TOP/s |
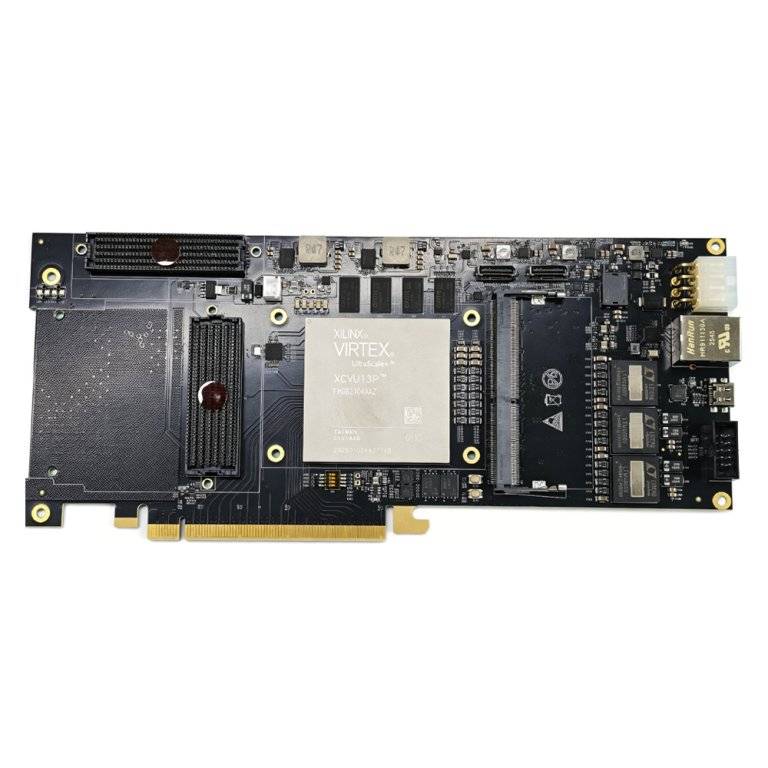
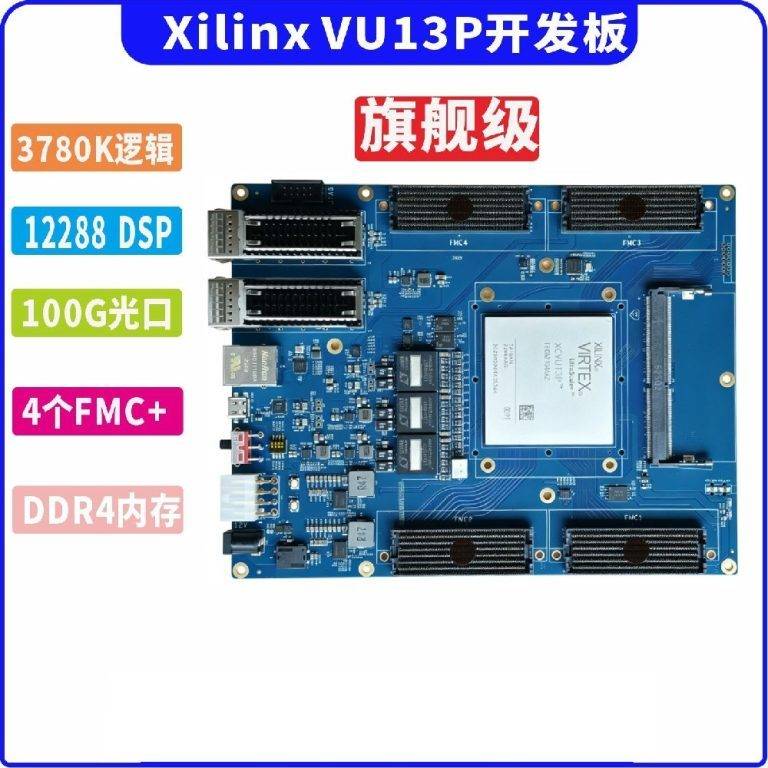
ボードレベルでは、Duyuan Electronics の VU13P 超ハイエンド開発プラットフォームが PCIe Gen3 x16 ゴールドフィンガ、複数の 100G 光ポート(QSFP28)、FMC+ 高速拡張、DDR4 SODIMM 拡張、産業級 -40°C ~ 85°C を提供する。量的取引にとってこのボードは自然に 3 つを届ける:複数の取引所 feed を FPGA へ直接接続(光ポート + GTY)、相当な戦略ロジックを FPGA 内部に配置(378 万 LC + 12,288 DSP)、高帯域双方向ホスト相互接続(PCIe Gen3 x16)。
3. 量的取引チェーンにおける VU13P の 4 つのコア応用
3.1 マーケットデータ復号と前処理(Feed Handler)
取引所マーケットデータプロトコル(NASDAQ ITCH、CME MDP3、欧州取引所がよく使う FAST 形式など)は極めて高いパケットレートで届く;ソフトのパースはパケットごとの復号・検証・構造再構築を要し、チェーンで最も早く典型的なボトルネックになる。VU13P 上ではマーケットデータ解析がハードパイプラインとして実装され:パケットは光ポートに入るなりバイトストリームとして復号され、フィールド抽出・検証・プロトコル再組立が固定パイプライン段で完了し、複数 feed(複数取引所、A/B 主回線・予備回線)が並行処理される。128 個の GTY トランシーバと複数 100G 光ポートが同時接続容量を豊富に提供;主/予備の二重回線(CME の A/B 回線など)では回線調停とシームレスなフェイルオーバをハード実装でき、単回線ジッタによるマーケットデータ欠落を回避する。パース済みの標準マーケットデータ構造はオンチップストレージへ直接書かれ下流戦略モジュールへ渡り、ホスト CPU を一切通過しない。
3.2 ハードウェア・オーダーブックと並列戦略実行
照会可能なオーダーブックの保守には頻繁な挿入・削除・更新・ソートが要り;ソフト実装はメモリアクセスとロックに頼るが、ハード実装は価格レベルをオンチップ Block RAM 構造へ直接マッピングし、価格照会とマッチング判断を固定サイクルで完了させる。この上に、VU13P の 378 万 LC は単一デバイス上で複数戦略インスタンスの並列実行を許す:異なる銘柄、異なる市場、さらに異なる戦略ロジック(マーケットメイキング、クロス市場アービトラージ、遅延アービトラージ、統計的回帰)が独立したロジックパーティションを占有し、同一のパース済みマーケットデータストリームを干渉なく共有できる。遅延敏感なトリガ戦略には「プリアーム発注」方式が使える:発注テンプレートを事前に送信バッファへ書き込んでおき、ハードが設定条件(価格ブレイクスルー、出来高比変化)を検知すると直接送信をトリガし、ソフト判断パスを迂回して遅延を数十 ns へ圧縮する。
3.3 発注前リスク
取引所とコンプライアンス枠組みはアルゴリズミック取引へのリスク要求をますます厳しくしている:価格帯幅、1 注文あたり数量上限、累積日次ポジション、発注頻度などのチェックを発注前に完了させねばならない。ソフトのリスクチェックの問題はクリティカルパス上に居て遅延を足すことだ;FPGA のリスクチェックはチェックロジックを発注パスと並列に置き——各発注はハードパイプラインの数段のリスクチェックを通過し、承認されれば即符号化送信、拒否ならナノ秒でブロックされる。リスクルールはレジスタ/メモリテーブルで設定し、取引日内のホット更新も可能で、メインパスの低遅延を犠牲にせずコンプライアンス要求を満たす。
3.4 バックテスト、シミュレーション、研究開発加速
本番チェーンを超え、VU13P の大きなロジック資源は戦略研究開発も支える:開発ボードにマーケットデータリプレイ・シミュレーションエンジンを載せ、ハードレベルで過去データに対するバックテストを行い、複数戦略を並列実行——ソフトシミュレーションより大幅に速い;Vivado/Vitis HLS で C/C++ アルゴリズムを素早くハード実装へ写像し、「戦略着想 → 試験可能ハード」の反復周期を縮める。典型的な工学体制は「FPGA が本番パス、CPU が監視と分析」:本番の発注とマーケットデータ処理は完全にカード上で行われ、ホストは PCIe Gen3 x16 経由で状態を読み、戦略パラメータとリスクルールを押し下ろし、性能と運用を両立する。
4. 典型的エンドツーエンド・システム構成
VU13P ベースの量的取引プラットフォームの典型トポロジ:
- マーケットデータ入り口:取引所 feed が 100G 光ポート(QSFP28)経由で FPGA へ直接入り、128 GTY ペアが複数回線を担う;
- ハード解析:Feed Handler モジュールがプロトコル(ITCH/FAST/MDP3 など)に従いパイプラインで復号・検証・A/B 回線調停;
- オーダーブックとシグナル:オンチップ BRAM が複数銘柄のオーダーブックを保守し、戦略パーティションが並列にシグナルを計算、トリガ条件成立で発注生成;
- リスクと符号化:発注は発注前リスクチェックを通過し、取引所プロトコルメッセージへ符号化されて送信バッファへ;
- ホスト相互接続:発注確認、約定通知、状態監視が PCIe Gen3 x16 経由でホストへ;戦略パラメータとリスクルールはホストから押し下ろす;
- 拡張インターフェース:FMC+ がカスタム NIC/アクセラレータ子カード接続、OCULINK がボード間高速相互接続で多ボードスケールに使われる。
展開形態としては、VU13P 開発ボードをサーバ内の PCIe アクセラレータカードとして直接使える;ラックスペースと電力に敏感な場面では、このプラットフォームを基により低消費電力のコアボード形状をカスタム可能。
5. VU13P が他方式に対して持つ工学的アドバンテージ
| 次元 | VU13P(FPGA)の相対アドバンテージ |
|---|---|
| エンドツーエンド遅延 | フルチェーン 300ns–1µs、プリトリガ 30–100ns;ソフト方式は通常 1–100µs |
| 遅延決定論性 | 固定パイプライン深度、割り込み/スケジューリングジッタなし、リスクと監査に好適 |
| 並列容量 | 3,780K LC + 12,288 DSP、複数戦略/銘柄を同時実行 |
| インターフェース帯域 | 128×GTY、複数 100G 光ポート、PCIe Gen3 x16、マルチ取引所直結 |
| 柔軟性 | 再構成可能:戦略変更は設定/再ロード、ボード交換不要;ASIC より開発周期がはるかに短い |
| 開発敷居 | ASIC より低い;Vitis HLS/OpenCL が C/C++ から写像、クリティカルパスは RTL でさらに最適化 |
CPU 比:VU13P は遅延と決定論性でオーダーリード;GPU 比:GPU はバッチスループットに強いがパイプラインとスケジューリングが遅延ジッタを入れ込みナノ秒クリティカルパスには不向きで、VU13P の決定論遅延が自然に適合;ASIC 比:ASIC は性能最良だが一時コストと開発周期が高くつき、完全に凍結したアルゴリズムにしか向かず、VU13P は戦略進化の柔軟性を保つ。だからこそプロップ取引会社は「クリティカルパスは FPGA、研究とオフライン計算は CPU/GPU」を標準分担として広く採用する。
6. 開発・展開のツボ
- ツールチェーン分担:クリティカルパス(プロトコル解析、発注符号化)は RTL で遅延を保証;戦略ロジックは Vitis HLS / OpenCL で素早く実装し、まずソフトシミュレーションで挙動を検証してからハードへ合成;
- モジュラインターフェース:Feed Handler、Order Book、Strategy、Risk、Gateway が AXI-Stream データインターフェースを統一使用し、置換・再利用・チーム協業を容易に;
- クロックと同期:マルチボード/マルチサイト展開では PTP/1PPS と低ジッタクロックツリーを導入し時間基準を統一、約定通知とマーケットデータのタイムスタンプ整合を保証;
- 標準ボードから始める:まず VU13P 開発ボードでマーケットデータ解析と戦略検証を完了し、遅延チェーンを通し切ってから、プロジェクト要件に合わせボード形状(インターフェース数、電力、機械構造)をカスタム;
- 監視と回帰:ハードロジックに統計カウンタと ILA 観測点を残し、取引日内に各段のパイプライン遅延を監視、劣化があれば素早く特定できるように。
7. 限界と選定推奨
FPGA がすべての量的シナリオの答えではない。戦略が分/時間オーダーでリバランスする場合、あるいは大規模機械学習特徴に依存し複雑モデルを頻繁に反復する場合は、CPU/GPU ソフトスタックのコストと柔軟性のアドバンテージがより明確;チームにハード開発能力がなければ、FPGA プロジェクトの評価・デバッグ・保守周期を十分に見積もる必要がある。ハード低遅延が要件と確定したら、リソース必要度で階層選定できる:
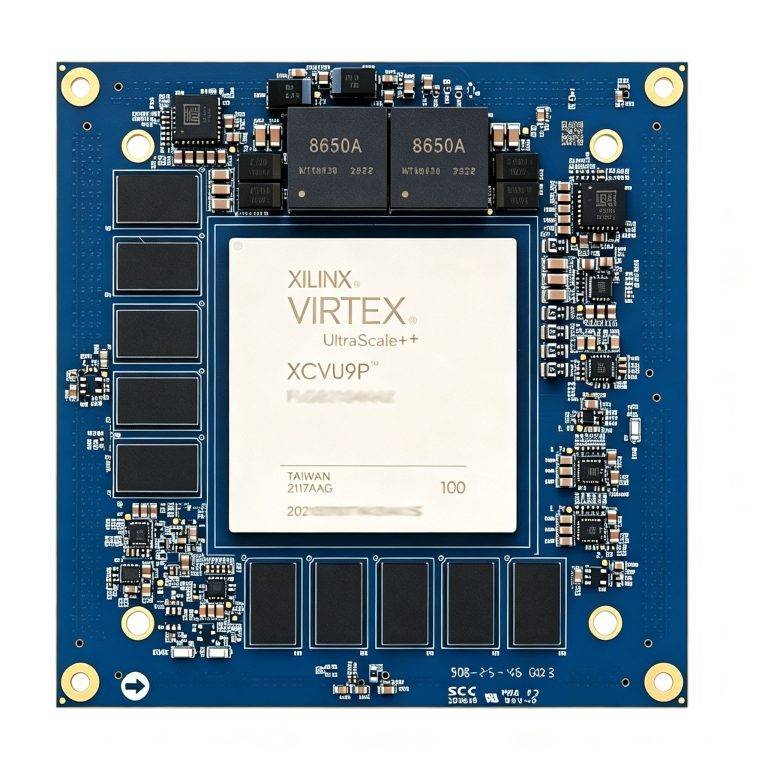
- VU9P:2,586K LC、6,840 DSP、2×200G + 4×100G 光ポート、32GB DDR4 ECC、PCIe x16——マーケットデータ入り口が大きくストレージ/帯域を重視する場面向け;
- VU13P:3,780K LC、12,288 DSP、128×GTY——並列マルチ戦略、複雑な戦略ロジック、オンチップ資源をより必要とする場面向け、このクラスの総合的な主力プラットフォーム;
- VU13F:同じく 12,288 DSP、4×FMC+ で豊富な拡張 IO と子カードインターフェースを提供——カスタム NIC や RF フロントエンドなど外部ハードを要するシステム統合向け。
注記:本稿の遅延数値は公開資料による代表レンジ。実値はプロトコル、パケットレート、戦略実装、ボード配線に依存する。選定と検収は現場測定に基づくべき。
8. おわりに
量的取引のハード化は何年も前から確定したトレンドだ:最初の NIC オフロードから、マーケットデータ解析と発注チェーン全体の FPGA 移設を経て、今日では VU13P クラスの単一デバイスがマルチ市場データ・マルチ戦略・リスク管理を同時に担うまでになった。VU13P の価値は「規模」と「速度」を同一デバイスに載せた点にある——複雑な戦略組合せがハードで並列走行する十分なロジックと DSP、マルチ取引所入り口がボトルネックにならない十分な GTY と 100G 光ポート。Duyuan Electronics は VU13P/VU9P 標準開発ボード、カスタムコアボード、マーケットデータ復号と低遅延チェーン IP パッケージ、エンドツーエンド技術サポートを提供し、評価ボード検証から展開可能な量的取引ハードプラットフォームまでを素早く支援する。
参考资料
- AMD, Virtex UltraScale+ FPGA 製品ページ(XCVU13P 仕様):amd.com 公式
- AMD/Xilinx + LDA, CME Tick-to-Trade 25 ナノ秒リファレンスソリューション
- libfpga, FPGAs in high-frequency trading: the anatomy of a nanosecond(tick-to-trade 遅延比較)
- Enyx, nxFramework(100ns 未満 tick-to-trade プラットフォーム)
- *Computer Applications and Software* 2025, OpenCL ベース超低遅延マーケットデータ加速システムの設計と実装
- ACM, DSL Programmable Engine for High Frequency Trading Acceleration(FAST プロトコル加速)
Duyuan Electronics · 応用実践 | データは 2026 年 9 月時点。各機関の範囲が異なるため出典を付記。