FPGA によるリアルタイム産業用外観検査:GigE カメラから欠陥キャリブレーションまで
量産ラインの欠陥検査において、カメラのピクセルから排除信号までの一連の流れの中で、FPGA が唯一無二の役割を担うのはどこか?本稿ではまずデータフロー全体の帯域予算を試算し、次にビジョン処理パイプラインの中で FPGA が担う 4 つの役割を分解し、伝統的アルゴリズムと深層学習のリアルタイム限界を比較したうえで、PCB はんだボールの AOI ステーションの実例を通じて、そのまま導入可能なハードウェア選定までを示す。
1. まずは帯域の会計:1080p60 ラインのデータフロー
産業用ビジョンにおける最初の難関はアルゴリズムではなく帯域だ。最もありふれたライン構成——1080p・60fps の GigE Vision カメラ 1 台——から、そのデータレートを計算する:
| 出力フォーマット | 計算式 | 結果 | ギガビットリンクに乗るか |
|---|---|---|---|
| 8-bit Bayer(最も一般的) | 1920 × 1080 × 8 bit × 60 | ≈ 995 Mb/s ≈ 124 MB/s | 1 Gbps の 99.5% を飽和、ぎりぎり |
| 12-bit Bayer(HDR/低光量) | 1920 × 1080 × 12 bit × 60 | ≈ 1.49 Gb/s ≈ 187 MB/s | ギガビットを超過。2.5G/10G または CoaXPress が必要 |
| 8-bit カメラ 4 台 | 995 Mb/s × 4 | ≈ 4 Gb/s ≈ 500 MB/s | 4 系統のギガビット集約または 10G アップリンクが必要 |
この生フレームをそのまま CPU や GPU に丸ごとストリーミングすると、1 チャネルあたり 124–187 MB/s を押し込み続け、4 チャネルなら 500 MB/s に達する。CPU 側でもフルフレームを処理しなければならず、帯域と計算を両端で浪費する。欠陥検出に実際に必要なのは「異常の位置・種類・座標」だけ——多くの場合、わずか数百バイトである。
鍵は:ピクセルをどこで処理するかが、パイプライン全体のコストを決める
生フレームをどこかへ移して処理するのは「運び屋」の発想。ピクセルが流れてくるその場で処理するのが「パイプライン」の発想だ。前者はカメラを 1 台増やすごとに 1 チャネル分の帯域と計算を追加し、後者は処理ロジックだけを追加する。
2. ビジョンパイプラインにおける FPGA の 4 つの役割
役割 1:インターフェースの立ち上げと複数カメラの同期
GigE Vision / CoaXPress のプロトコル解析、カメラパラメータの設定、トリガ管理は、FPGA の MAC 層とトリガロジックが直接担当する。複数カメラは同一のハードウェアトリガクロックにロックし、異なるアングルのフレームが同一瞬間に露光されることを保証する——ソフトウェアでは決定論的に実現が難しい特性だ。
役割 2:画像前処理(ノイズ除去・ゲイン・ベイヤー補間)
ノイズ除去、ホワイトバランス、ゲイン、ベイヤー補間、ROI 抽出——これらはすべて画素ごとの演算だ。FPGA パイプラインはクロック 1 サイクルに 1 画素を自然に進め、1080p60 のピクセルクロックは約 148.5 MHz で、JFM7K410T のようなデバイスでは十分にタイミング余裕の範囲内だ。同じ画素ごとの処理を CPU でやればフレームあたり数ミリ秒〜数十ミリ秒のループになるが、FPGA なら数十クロックの固定遅延で済む。
役割 3:欠陥検出(テンプレート・差分・連結成分)
テンプレートマッチング、フレーム差分、二値化、連結成分解析、モルフォロジ処理——すべて並列可能、すべてパイプライン化可能。1080p 画像に対するテンプレートマッチングは FPGA 上でフレームあたり 1 ms 未満で動作し、遅延はフレームレートに依存せず完全に決定的——ラインのサイクルタイムに対する必須要件だ。
役割 4:結果出力と IO 協調
判定結果は直ちに排除アクチュエータ、警報ランプ、統計カウンタを駆動する。FPGA の GPIO 出力遅延はナノ秒級で、OS やドライバ、アプリケーション層を一切経由しない。欠陥が現れた瞬間には、排除信号はすでにアクチュエータに届いている。
3. 2 つのアルゴリズム経路:伝統的ビジョンと深層学習
「深層学習を足せばいい」はここ数年のビジョン案件の決まり文句になっているが、両者のリアルタイム境界は明確に引いておく必要がある:
| 比較項目 | 伝統的ビジョン(テンプレート/差分/モルフォロジ) | 深層学習(CNN/YOLO 系) |
|---|---|---|
| 1080p 単フレーム遅延 | 1 ms 未満(FPGA パイプライン) | 2–10 ms(GPU)またはそれ以上(汎用 NPU) |
| リソース占有率 | 小さな LUT/DSP 数 | 重い DSP + 外部メモリ帯域 |
| 解釈可能性 | 閾値調整可能、欠陥のトレース容易 | ブラックボックス、誤検出の原因特定が困難 |
| 最適な用途 | 固定パターンの欠陥、高速サイクルライン | 複雑な欠陥、多様サンプルのオフライン再検査 |
| FPGA での実装 | 成熟、高度にエンジニアリング済み | 量子化/枝刈りが必要、通常は CPU/GPU 上 |
2026 年の主流ライン構成は FPGA による前処理 + 伝統手法によるリアルタイム判定 + 深層学習によるオフライン再チェックだ。FPGA がサイクルタイム内の判定と排除を保証し、深層学習が疑わしい領域の二次確認を担当する——それぞれが最も得意なことをやる分担である。
4. 実例:PCB はんだボール AOI ステーション
エンジニアリング事例・01:SMT ラインのはんだボール検査——60 fps 連続、誤報率 0.5% 未満
SMT ラインの AOI ステーションは、冷はんだ、ブリッジ、部品欠落を検出し、60 fps で連続稼働し、誤報率 0.5% 未満、冷はんだの見逃し率 1% 未満を目標とする。
- カメラ:2 × GigE 20 MP 産業用カメラ、実際は 1080p ROI にクロップ、8-bit Bayer 出力
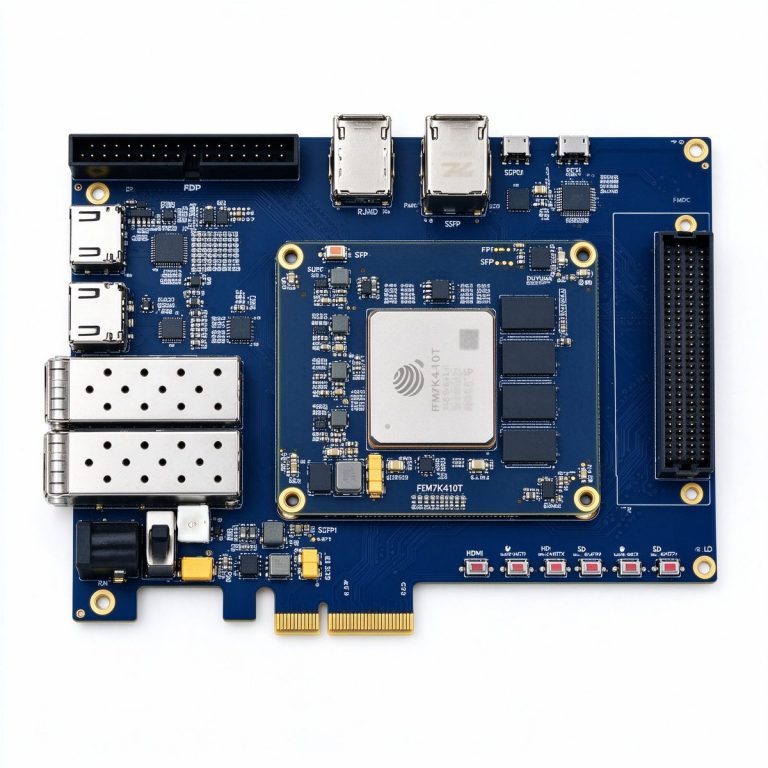
- ボード:DUK7410T(复旦微 JFM7K410T、406K ロジックセル、FMC HPC、4 GB DDR3)
- データフロー:2 × 995 Mb/s ≈ 2.5 Gb/s で FPGA に入力 → DDR フレームバッファ → テンプレート差分 + 連結成分解析 → 判定出力
実測結果:単フレーム処理 0.8 ms 未満;カメラトリガから排除出力までのエンドツーエンド遅延 1.5 ms 未満;誤報率 0.5% 未満;冷はんだ検出率 99% 超。
CPU ベースラインとの比較:エンドツーエンド遅延は約 15 ms から 1.5 ms 未満へ低下、ホスト CPU 負荷は 85% から 5% へ——従来のソフトウェアパイプラインは 30 fps が限界だった。FPGA への切り替えでスループットは 2 倍になった。
このステーションの鍵は派手なアルゴリズムではない——検査動作がラインのサイクルに追いつくことだ。欠陥フレームが届いた瞬間、次のフレームが来る前に判定と排除を完了しなければならない。
5. ハードウェア選定の指針:3 つのボード、3 つの戦略
選定は 3 つの問いに従う:カメラは何台必要か?遅延要件はどれほど厳しいか?装置全体の予算はいくらか?ここでは Duyuan の代表的な 3 つのプラットフォームを挙げる:
DUK7410T(¥9,999)——ミドルクラスの主力、1/2 カメラ AOI のスタンダード
复旦微 JFM7K410T、406K ロジックセル、1,540 DSP、FMC HPC、HDMI 4K 入力、2× SFP+。FMC HPC は高速カメラや ADC メザニンに直接接続でき、HDMI 4K 入力はディスプレイループバックにも兼用できる。ビジョン位置決め、欠陥検出、多チャネルステッチの試作——多くのプロジェクトはここから始まる。
PBC7K325G(¥1,999)——コスト重視の組み込み機器へ
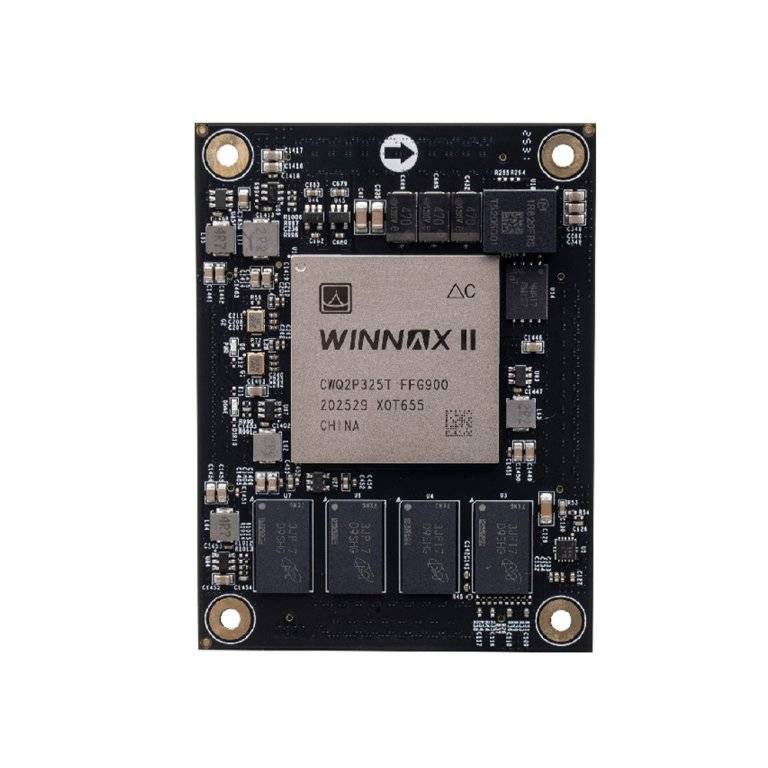
中国 Kintex-7 アーキテクチャ SoM、326K ロジック、16 GTX トランシーバ、2 GB DDR3、産業グレード -40〜85 °C。単カメラ・固定パターンの組み込み検査、あるいはビジョン + モーションコントロールの複合コントローラ。コスト重視の製品はここから出荷される。
DUF7690T(¥24,999)——マルチカメラアレイと高性能複合システム
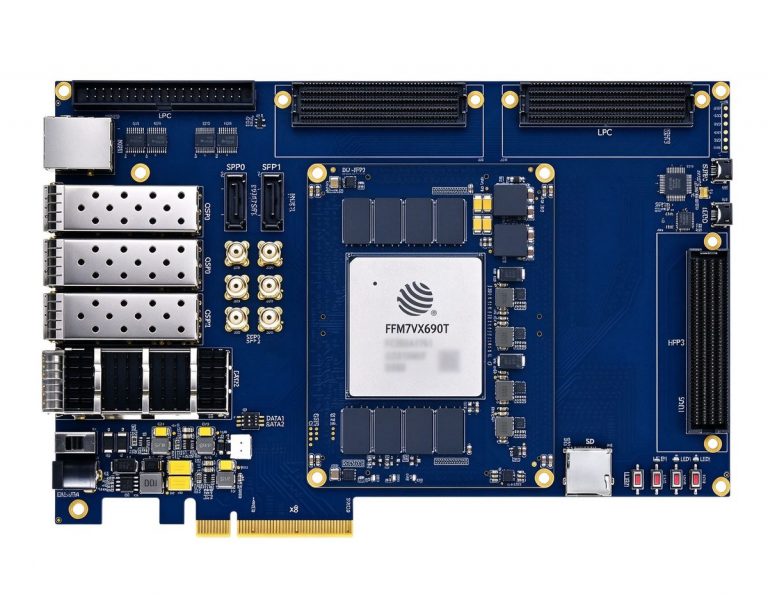
复旦微 JFM7VX690T、693K ロジックセル、3,600 DSP、36 GTH ペア、QSFP 40G。8 台以上のカメラアレイ、8K ステッチ、あるいはビジョン + 光通信の複合システム——大きなロジックと大きな帯域が必要になったら、このボードへランクアップする。
産業用ビジョンの第一原理は「フレーム全体をあちこちに送り回さない」こと——ピクセルが流れる場所で処理すれば、遅延・帯域・消費電力の問題は一度に消える。
>
—— Duyuan 電子 研究開発チーム