PCIe 帯域の設計:Gen3 x4 から x16 まで、実効帯域はどれだけ得られるか
PCIe の帯域会計は、データシートの数字よりはるかに複雑だ——生帯域、符号化オーバーヘッド、プロトコルオーバーヘッド、DMA 効率、DDR のボトルネックが、その「16 GB/s」を少しずつ削っていく。本稿では Gen3 x4/x8/x16 を、DDR や DMA のマッチングまで含めて試算し、実効帯域を見積もる再利用可能な方法を示す。
1. 帯域の 3 層:生・符号化後・実効
仕様書で「PCIe Gen3 x16」を見ると、直感的には 16 GB/s と読む。しかしその数字は実際には生のビットレートであり、システムで使える帯域ではない。間には 2 層の損失が挟まる:
| 層 | Gen3 x16 の計算 | 結果 | 意味 |
|---|---|---|---|
| ① 生ビットレート | 16 レーン × 8.0 GT/s | 128 Gb/s | リンク上の生シンボルレート |
| ② 符号化後帯域 | 128 × 128/130(Gen3 は 128b/130b) | ≈ 126 Gb/s ≈ 15.75 GB/s | 符号化オーバーヘッド後のペイロードレート |
| ③ 実効帯域 | 15.75 × 転送効率(80%–90%) | ≈ 12.6 – 14.2 GB/s | TLP ヘッダー、DMA ディスクリプタ、割り込みを差し引いた実使用帯域 |
Gen3 はレーンあたり 8.0 GT/s で、128b/130b の符号化オーバーヘッドはわずか 1.5%——Gen2 の 8b/10b(20% オーバーヘッド)よりはるかに効率が良い理由だ。幅ごとの比較:
| PCIe 幅 | 生ビットレート | 符号化後帯域 | 実効帯域(大容量 DMA) |
|---|---|---|---|
| Gen3 x4 | 32 Gb/s | ≈ 3.94 GB/s | ≈ 3.2 – 3.5 GB/s |
| Gen3 x8 | 64 Gb/s | ≈ 7.88 GB/s | ≈ 6.3 – 7.1 GB/s |
| Gen3 x16 | 128 Gb/s | ≈ 15.75 GB/s | ≈ 12.6 – 14.2 GB/s |
| Gen2 x8(参考) | 40 Gb/s | ≈ 4.0 GB/s(8b/10b) | ≈ 3.2 – 3.6 GB/s |
2. プロトコルオーバーヘッドの中身:TLP・ペイロード・読み書き
符号化後帯域は実効帯域ではない。PCIe トランザクションレイヤパケット(TLP)は 12–20 バイトのヘッダを持ち、ペイロードが大きいほどヘッダの比率は小さくなり効率は上がる。
ペイロードサイズが効率を直接決める
| ペイロードサイズ | TLP ヘッダ比率 | 転送効率 | 代表的なシナリオ |
|---|---|---|---|
| 4 KB(最大) | ≈ 0.4% | ≈ 90%+ | 大容量連続 DMA 収録、映像ストリーム |
| 512 B | ≈ 3% | ≈ 85–88% | 汎用データ回送 |
| 64 B | ≈ 25% | ≈ 55–65% | レジスタ読み書き、小パケット制御 |
読み出しは書き込みより遅い:完了応答の隠れコスト
PCIe 書き込みは fire-and-forget で、送信側は確認を待たない。PCIe 読み出しは Completion TLP が戻るのを待つ必要があり——往復で遅延が倍増し帯域も消費する。実測:
- 大容量シーケンシャル書き込み:符号化後帯域の 88–92%
- 大容量シーケンシャル読み出し:通常 80–85% どまり(Completion のキューイング、オーバーヘッド)
- 読み書き混合:方向切り替えがリンクを停滞させ、効率がさらに 5–10% 低下
設計では、理想値の 90%+ ではなく保守的に「実効帯域 = 符号化後 × 80%」で見積もり、余裕を持たせる。
3. DDR が本当の天井
速い PCIe リンクはシステムが全速で動くことを意味しない——FPGA の内外をデータが DDR を通過する必要があり、DDR 帯域が最初の壁になることが多い。
DDR 帯域の計算方法
DDR 帯域 = データバス幅 × データレート / 8。Duyuan の代表的なボード:
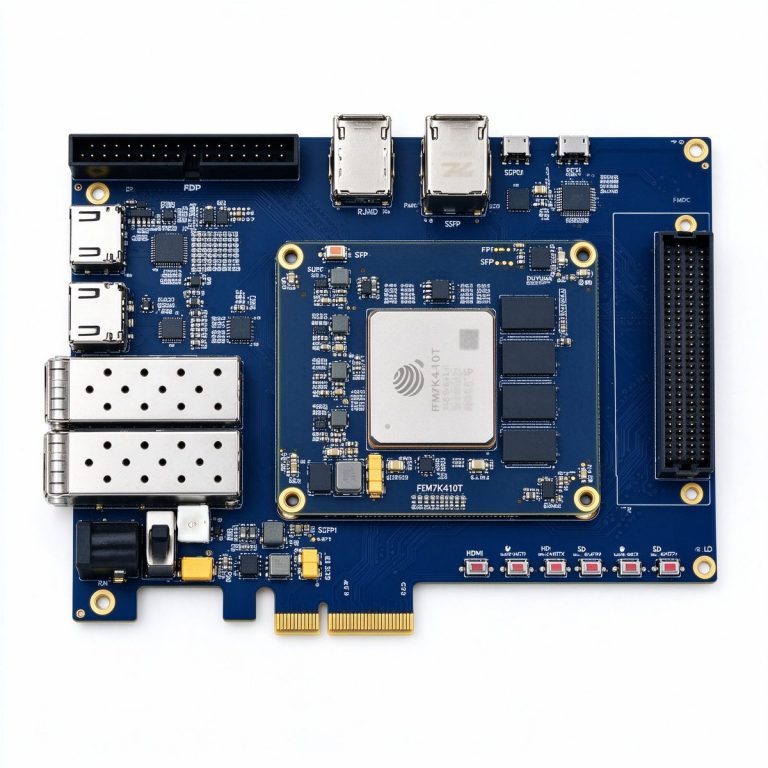
- DUK7410T:4 GB DDR3、64-bit バス、1866 Mbps → 64 × 1866 / 8 ≈ 14.9 GB/s
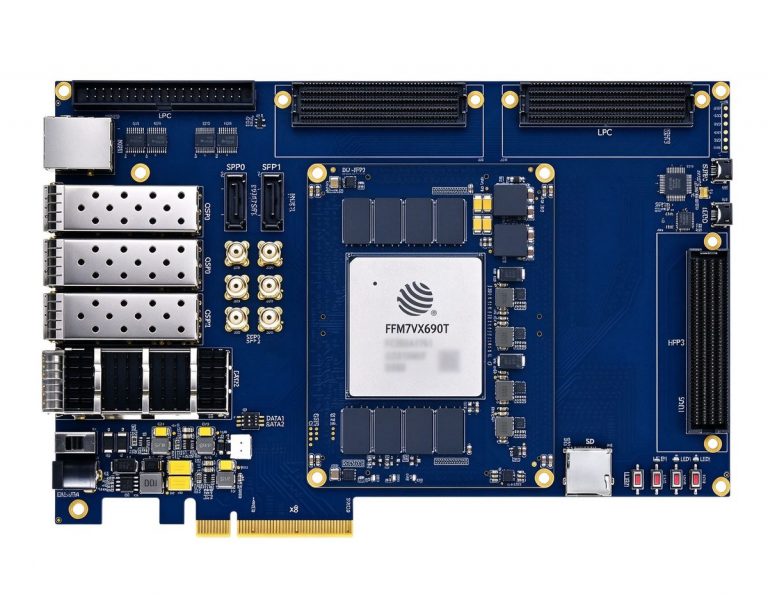
- DUF7690T:4 GB DDR3、64-bit、1866 Mbps → ≈ 14.9 GB/s
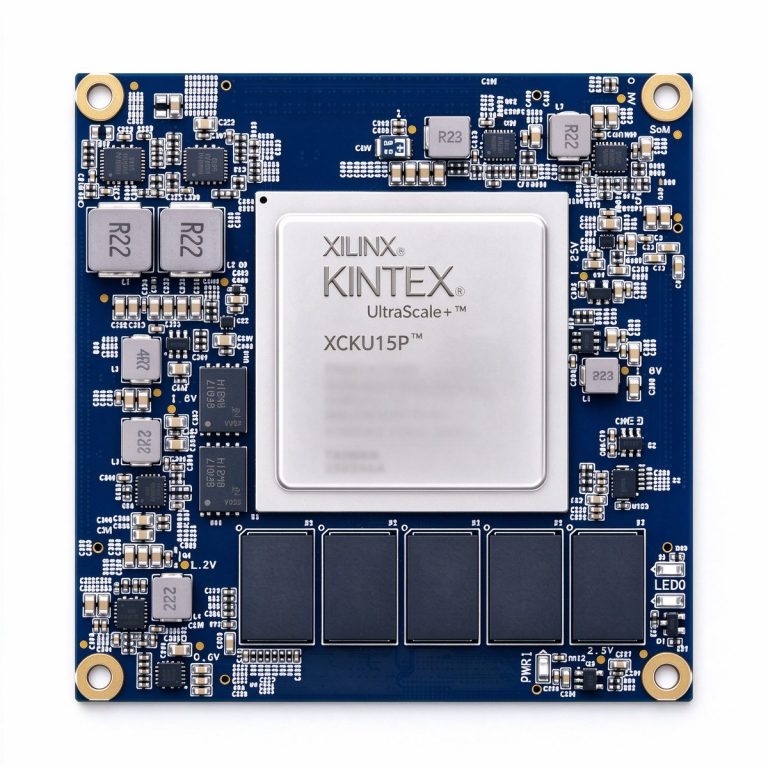
- DUKU15P:8 GB DDR4 ECC、64-bit バス(+8-bit ECC)→ 2400 MT/s で ≈ 19.2 GB/s
データフローは双方向:読み書きで負荷が倍増
高速収録シナリオを考える:ADC データは FPGA で処理され、PCIe 経由でホストへ書き戻される。このパスは DDR を 2 回通過する:
- FPGA がデータ受信 → DDR 書き込み(フレームバッファ)
- FPGA 処理完了 → DDR 読み出し(送信分の取り出し)
- DDR 総負荷 = 書き込み帯域 + 読み出し帯域
PCIe x8 Gen3 の実効帯域が 7 GB/s なら、DDR は同時に 7 GB/s の書き込みと 7 GB/s の読み出し = 14 GB/s を捌く必要があり——DDR3 の物理限界 14.9 GB/s に迫り、FPGA のアルゴリズム処理にほとんど余裕が残らない。だから x8 Gen3 + DDR3 が「黄金の組み合わせ」であり、x16 には DDR4 が必要になる。
| ボード | PCIe 仕様 | 符号化後帯域 | DDR 構成 | DDR 帯域 | 適合判定 |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4.0 GB/s | 4 GB DDR3 64-bit | ≈ 14.9 GB/s | PCIe がボトルネック、DDR に余裕 |
| DUF7690T | Gen3 x8 | ≈ 7.88 GB/s | 4 GB DDR3 64-bit | ≈ 14.9 GB/s | 各方向約 7.5 GB/s、ちょうど釣り合う |
| DUKU15P | Gen3 x16 | ≈ 15.75 GB/s | 8 GB DDR4 64-bit | ≈ 19.2 GB/s | PCIe 全負荷時に DDR が限界に迫る |
4. 3 ステップでの見積もり:プロジェクトに必要な帯域は?
方法論・01:PCIe 帯域の 3 段階見積もり
ステップ 1:実効需要を計算する。全データソースの生データレートを合計する——最低限転送しなければならない量だ。
ステップ 2:余裕係数をかける。オーバーヘッド、バースト、複信を見て 1.2–1.5 倍する。
ステップ 3:PCIe 幅を逆算する。符号化後帯域 ≥ 余裕込み需要となる仕様を選び、次に DDR が追いつくかを検証する。
3 つの代表シナリオで検証:
| シナリオ | 生データレート | 余裕込み需要 | 推奨 PCIe | 理由 |
|---|---|---|---|---|
| 高速収録(2ch × 250 MSPS × 14-bit) | ≈ 875 MB/s | ≈ 1.1 – 1.3 GB/s | Gen3 x4(3.94 GB/s) | 余裕十分、DDR も無負荷 |
| 4K60 キャプチャ&処理(10-bit 4:2:2) | ≈ 1.5 GB/s | ≈ 1.8 – 2.3 GB/s | Gen3 x8(7.88 GB/s) | 多チャネル映像やステッチにも余地 |
| AI 推論の特徴マップ一括回送 / 8K 映像 | ≈ 10 – 12 GB/s | ≈ 12 – 18 GB/s | Gen3 x16(15.75 GB/s) | DDR4 が必要、さもなくば DDR が先に壁になる |
経験則:PCIe 幅を選ぶときは実効需要 × 2 から逆算し、倍の余裕を残す。帯域は後から上げられても、幅はボード再設計なしには上げられない。
5. Duyuan の 3 つの PCIe プラットフォームから選ぶ
DUK7410T(¥9,999)——コスト重視の収録・処理
复旦微 JFM7K410T、PCIe Gen2 x8 ハード IP、符号化後約 4 GB/s。FMC HPC メザニンと組み合わせた高速 ADC 収録や、HDMI 4K 映像処理に——PCIe 帯域がボトルネックでない場面はここから始める。
DUF7690T(¥24,999)——主流の収録・複合処理
复旦微 JFM7VX690T、PCIe Gen3 x8 ハード IP、符号化後約 7.88 GB/s。4 GB DDR3 と各方向約 7.5 GB/s で x8 フル帯域にマッチする。多チャネル収録、レーダー信号処理、映像ステッチ向けの主力プラットフォーム。
DUKU15P(¥15,999)——ハイエンドのデータ回送と 100G 相互接続
AMD Kintex UltraScale+ XCKU15P、PCIe Gen3 x16 ハード IP、符号化後 15.75 GB/s、8 GB DDR4 ECC を組み合わせる。56 個の高速トランシーバ(24× GTY 28G + 32× GTH 16G)と 4× 100G イーサネットハード IP を統合——大帯域 PCIe 回送と高速ネットワークを併用する場面の旗手的選択。
PCIe 帯域は「インターフェースの速度」では決まらない——「インターフェース × メモリ × DMA」の最短の板である。まず DDR の余裕を設計し、それから PCIe の速度を語る。
—— Duyuan 電子 研究開発チーム